FSRS là gì? Thuật toán ôn tập thông minh hơn thế hệ cũ
Bài trước trong cụm này giải thích vì sao ôn đúng lúc sắp quên mới giữ được từ. Bài này trả lời câu hỏi kế theo: chính xác thì "đúng lúc" là khi nào? Với người nhanh, ba ngày là quá trễ; với người chậm, ba ngày là quá sớm. Cùng một từ, học buổi sáng thì quên chậm hơn học lúc nửa đêm mệt rũ. Một lịch cố định cho mọi người mọi từ là thô sơ — và FSRS (Free Spaced Repetition Scheduler) là câu trả lời hiện đại cho vấn đề đó. Dual Dictionary chạy nó ở hàng đợi ôn, nên bài này cũng giải thích đúng cái đang chạy trong app của bạn.
Vấn đề: lịch ôn tốt phải là lịch của riêng bạn
Suy nghĩ tự nhiên đầu tiên: làm cái lịch "một ngày — ba ngày — một tuần — một tháng" là xong. Đó là cách thế hệ cũ làm, và nó hoạt động được — chỉ là hoạt động giông như người máy: mỗi thẻ được đối xử y hệt nhau dù không có hai từ nào bạn quên cùng tốc độ, và không có hai người nào quên cùng nhịp.
Hệ quả của lịch cứng: từ dễ thì vẫn bị kéo ra ôn dày hơn cần (lãng phí thời gian), từ khó thì bị đẩy đi xa đúng nhịp chuẩn dù bạn chưa nhớ vững (rơi mất). Cộng dồn qua vài trăm từ, phần trăm lãng phí + phần trăm rơi mất đó là chênh lệch thật giữa hai band.
FSRS giải vấn đề đó bằng cách nào
FSRS học từ chính hành vi của bạn. Mỗi lần bạn chấm một thẻ (nhớ / quên), thuật toán cập nhật ba ước lượng cho thẻ đó, của riêng bạn:
- Độ khó: từ này bạn quên nhanh hay chậm so với trung bình của chính bạn.
- Độ bền hiện tại: từ lần ôn gần nhất tới giờ, trí nhớ còn "trụ" được bao lâu.
- Tính dễ phục hồi: mỗi lần ôn thành công, từ này hứng thêm được bao nhiêu.
Từ ba ước lượng đó, FSRS dự báo xác suất bạn còn nhớ thẻ tại một thời điểm bất kỳ trong tương lai, và đặt lần ôn kế tiếp ở đúng chỗ xác suất đó sắp chạm ngưỡng (thường khoảng 90%). Nghĩa là: từ dễ của bạn được giãn lịch sớm hơn, từ khó được gặp dày hơn, và toàn bộ lịch tự tinh chỉnh theo tuần theo tháng — không phải bạn cài gì cả, chỉ việc trả lời trung thực.
Con số phụ đáng chú ý: FSRS dùng một bộ trọng số học từ hàng trăm nghìn lượt ôn thực tế của cộng đồng để khởi điểm — bạn hưởng lợi trí tuệ đám đông ngay từ thẻ đầu tiên, và app như Dual Dictionary còn cho "huấn luyện lại" trọng số theo chính log ôn của bạn khi đủ dữ liệu.
Khác gì thế hệ cũ (SM-2)?
Anki huyền thoại — và hầu hết app flashcard — chạy SM-2, thuật toán thập niên 80: đơn giản, bền bỉ, nhưng xếp lịch theo hệ số nhân cố định bạn tự chỉnh (lần sau = lần này × 2.5 chẳng hạn). SM-2 không biết "xác suất nhớ" là gì; nó chỉ nhân các con số. FSRS sinh sau hơn ba mươi năm, mô hình hóa thẳng vào đường cong quên và tối ưu bằng dữ liệu thật, nên với cùng một khối lượng thời gian, các so sánh độc lập thường cho FSRS giữ từ tốt hơn hoặc tốn ít lần ôn hơn — hai thứ đều là thời gian của bạn.
Nói công bằng: SM-2 cũng là người hầu tốt, và chênh lệch không phải trời với vực. Chênh lệch lớn nhất nằm ở người mới không biết chỉnh hệ số — FSRS chạy chuẩn ngay từ đầu, không cần am hiểu tinh chỉnh. Đó là lý do tôi chọn nó cho app của mình: đồng nghiệp tôi cần công cụ chạy được ngay, không cần đọc manual về các hệ số.
FSRS trong Dual Dictionary — và phần tôi thích nhất
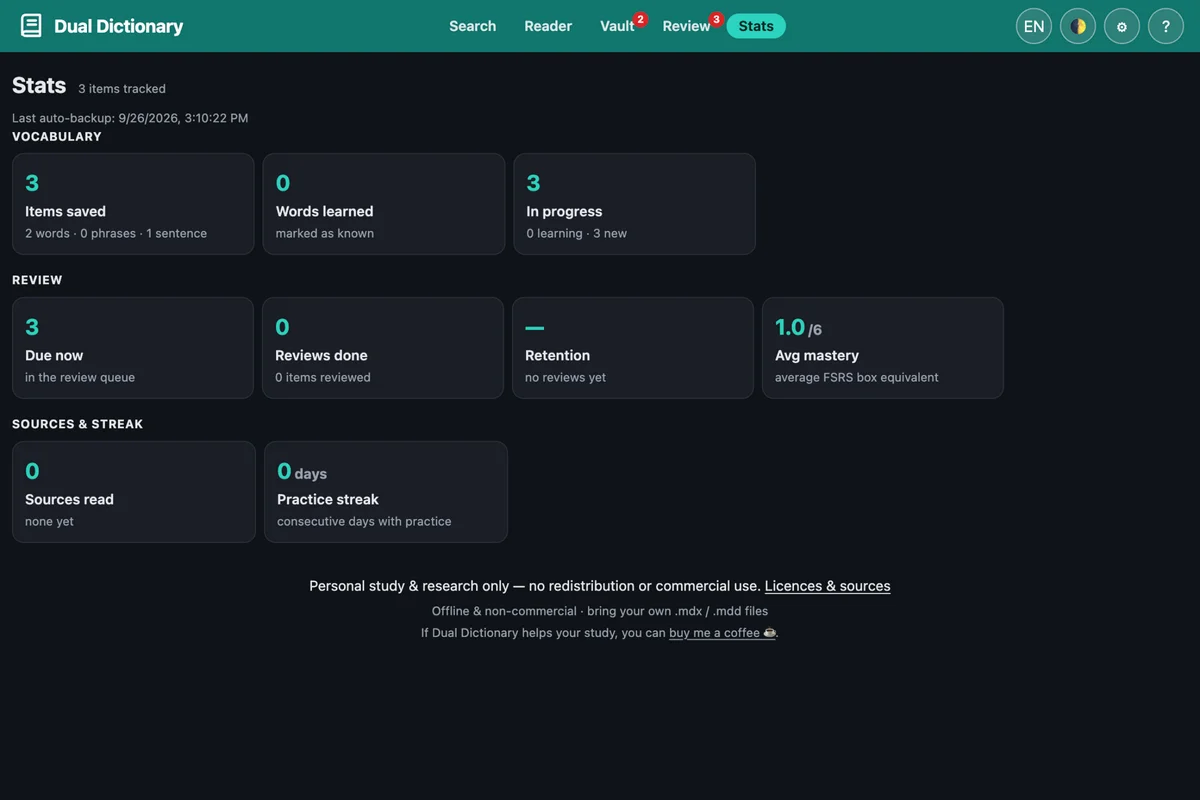
Trong app, hàng đợi ôn chạy FSRS toàn bộ: mỗi thẻ bạn lưu từ bất kỳ đâu (tra từ, Reader, Listening) tự vào lịch. Bạn chấm ba nút — Know it / Forgot / Skip — và lịch tự giãn nén theo. Không bảng cài đặt nào phải đụng tới.
Phần tôi thích nhất: khi log ôn của bạn đủ dày (khoảng 200 lượt, tốt nhất từ 400), app có nút tối ưu hóa — huấn luyện lại bộ trọng số FSRS theo chính lịch sử quên của bạn, ngay trên thiết bị. Cùng một thuật toán cộng đồng, nhưng lịch trở thành của riêng bạn theo đúng nghĩa đen. Và một điều nữa khớp DNA của app: toàn bộ việc này chạy offline trên máy bạn — lịch ôn là dữ liệu riêng tư nhất của người học, và nó không bao giờ rời khỏi thiết bị.
Đọc tiếp
- Spaced repetition là gì? — lý thuyết gốc mà FSRS là bản hiện đại.
- Cách học từ vựng IELTS để không bao giờ quên — FSRS nằm ở nguyên tắc số 3 của bài đó.
- Học TOEIC bằng flashcard: đúng cách và sai cách — FSRS ứng dụng thực tế với người thi, kèm cầu Anki.
Trải nghiệm FSRS ngay hôm nay — miễn phí, offline, không cần tài khoản.
Dual Dictionary: hàng đợi ôn FSRS tự xếp lịch riêng từng thẻ của bạn, huấn luyện lại theo chính dữ liệu của bạn khi đủ dày. Không tài khoản, không quảng cáo, không rời máy.
